Как обогнать быструю сортировку
Встречал точку зрения, что программистам не обязательно разбираться в алгоритмах. Дескать, все алгоритмы уже реализованы в стандартной библиотеке того языка, на котором вы пишите. Достаточно только уметь их вызывать. Часто данная точка зрения и вправду верна. Кроме тех случаев, когда это не так.
Для примера рассмотрим сортировку. Обычно применяется быстрая сортировка. Уверен, многие читатели данного блога могут написать ее по памяти. Помимо прочего, это популярный вопрос на собеседованиях.
Пример реализации на Python:
import random

def quicksort(arr):
    _quicksort(arr, 0, len(arr) - 1)

def _quicksort(arr, low, high):
    if low < high:
        split = _partition(arr, low, high)
        _quicksort(arr, low, split - 1)
        _quicksort(arr, split + 1, high)

def _partition(arr, low, high):
    chosen = random.randint(low, high)
    arr[chosen], arr[high] = arr[high], arr[chosen]
    pivot = arr[high]

    i = low
    for j in range(low, high):
        if arr[j] < pivot:
            arr[i], arr[j] = arr[j], arr[i]
            i += 1

    arr[i], arr[high] = arr[high], arr[i]
    return i
Тот факт, что алгоритм обладает асимптотической сложностью O(N2) в худшем случае и O(N·log(N)) в среднем случае, также не является секретом. Если вдруг вы начинающий разработчик, то данный вопрос, равно как и работа алгоритма в целом, подробно разобраны абсолютно в любой книге об алгоритмах.
Одна из модификаций быстрой сортировки выглядит так. Рекурсия всегда идет в меньшую часть массива, а большая обрабатывается итеративно. Я лично нахожу это спорным решением. При правильной реализации вероятность израсходовать стек и так стремится к нулю.
Способов выбора опорного элемента (pivot) существует много. Чтобы не налететь на худший сценарий, достаточно выбирать случайный. Помимо простоты и производительности быстрая сортировка привлекательна тем, что хорошо распараллеливается. Написать параллельную версию алгоритма – это еще один частый вопрос на собеседованиях.
Допустим, стандартная библиотека языка предлагает быструю сортировку. Примем ее асимптотическую сложность за O(N·log(N)). Это лучшее, что есть? Берем и используем? Вопрос закрыт? Сторонники точки зрения, озвученной в начале статьи, утверждают, что да. Но на самом деле быстрая сортировка не обязательно является лучшим выбором. Во всяком случае, не для любых входных данных.
На маленьких или почти отсортированных массивах сортировка вставками оказывается быстрее:
def insertion_sort(arr):
    _insertion_sort(arr, 0, len(arr) - 1)

def _insertion_sort(arr, low, high):
    for i in range(low + 1, high + 1):
        key = arr[i]
        j = i - 1
        while j >= low and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1
        arr[j + 1] = key
Если массив уже отсортирован, то алгоритм просто пройдет по нему за O(N), не выполнив ни одной перестановки. Если массив не отсортирован, то асимптотическая сложность составит O(N2). Тем не менее, на маленьких массивах, где-то от 8 до 32 элементов, сортировка вставками обгоняет быструю сортировку.
В силу названных обстоятельств быструю сортировку оптимизируют так:
INSERTION_SORT_THRESHOLD = 8

def hybrid_quicksort(arr):
    _hybrid_quicksort(arr, 0, len(arr) - 1)

def _hybrid_quicksort(arr, low, high):
    if high - low + 1 <= INSERTION_SORT_THRESHOLD:
        _insertion_sort(arr, low, high)
    else:
        split = _partition(arr, low, high)
        _hybrid_quicksort(arr, low, split - 1)
        _hybrid_quicksort(arr, split + 1, high)
Грамотно разработанная стандартная библиотека языка будет содержать эту оптимизацию. Но тогда выходит, что сторонники идеи «алгоритмы знать не обязательно» все это время были правы? Не так быстро. Что, если я скажу вам, что существует алгоритм сортировки больших массивов за O(N)?
Кстати, мы не так давно вспоминали его в этом блоге. Называется сортировка подсчетом:
def counting_sort(arr, max_value):
    counts = [0] * (max_value + 1)
    for x in arr:
        counts[x] += 1

    pos = 0
    for value, count in enumerate(counts):
        for _ in range(count):
            arr[pos] = value
            pos += 1
Минус алгоритма – потребность в дополнительной памяти. Зато сортирует за O(N). Самое то, например, когда нужно отсортировать огромное количество чисел от 0 до 216. А что, если перед нами какие-нибудь ASCII-строки в нижнем регистре?
Нет проблем, просто адаптируем предыдущую идею:
PREFIX_LENGTH = 3

def _bucket_index(s):
    idx = 0
    for i in range(PREFIX_LENGTH):
        idx = idx * 26 + (ord(s[i]) - ord('a'))
    return idx

def bucket_sort(arr):
    buckets = [[] for _ in range(26 ** PREFIX_LENGTH)]
    for s in arr:
        buckets[_bucket_index(s)].append(s)

    pos = 0
    for bucket in buckets:
        if bucket:
            insertion_sort(bucket)
            arr[pos:pos + len(bucket)] = bucket
            pos += len(bucket)
Это называется корзинная сортировка, она же блочная или карманная. Строки группируем в корзины в соответствии с первыми тремя символами. Строки, начинающиеся на «aaa», идут в нулевую корзину, начинающиеся на «aab» – в первую и так далее. Затем применяем к корзинам сортировку вставками и объединяем результат. Чтобы это работало, распределение строк должно быть более-менее равномерным.
Проверим алгоритм на практике:
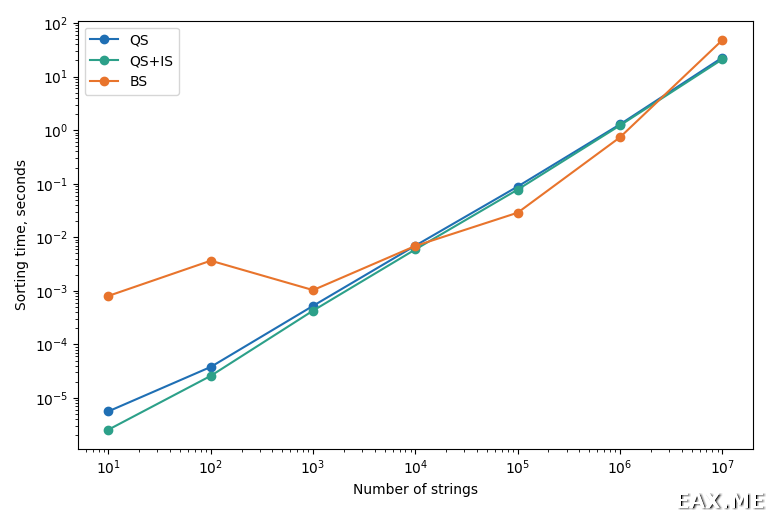
Скрипт, при помощи которого был построен график, можно скачать здесь. В данном случае он запускался на ноутбуке Xiaomi Redmibook Pro 16 2025. На вашем железе графики могут отличаться.
График QS соответствует быстрой сортировке со случайным опорным элементом. QS+IS – это тот же алгоритм с сортировкой вставками для маленьких массивов. QS+IS всегда опережает QS, в полном соответствии с написанным выше.
BS – это корзинная сортировка. Для малых массивов алгоритм неэффективен из-за накладных расходов. Но смотрите, что происходит на массиве из 105 строк. В логарифмическом масштабе плохо видно, но корзинная сортировка обогнала быструю сортировку более чем в два раза. Здесь каждая корзина в среднем получила 6 строк. На массиве из 106 строк результат менее впечатляющий при 57 строках на корзину. Наконец, на массиве из 107 строк корзинная сортировка проигрывает, ведь количество строк на корзину перевалило за 500.
Таким образом, мы установили, что, разбираясь в алгоритмах и обладая некоторой информацией о природе данных, можно существенно повысить производительность программы.